近期,Hotel Lobby AI 双人音乐说唱视频趋势风靡了各大短视频平台。该灵感源自知名音乐节目 A COLORS SHOW 的经典现场:在纯粹极简的橙色录音棚中,单只电容麦克风从顶部优雅垂挂,两位说唱歌手伴着动感 808 鼓点挥洒自如、双人互动。
无论你是想和好友一起变身说唱搭档、让二次元角色跨界联动,还是制作趣味创意内容,本篇深度实操教程将手把手带你了解 如何制作 Hotel Lobby AI 视频(How to do hotel lobby AI)的全流程,零剪辑基础也能轻松上手。
先看看影棚效果
开始前,先看看双人影棚的画面风格。该场景由无缝哑光暖橙色吸音棚壁、复古金属麦克风与纯正街头潮流服饰搭配而成:

纯正 Hotel Lobby 录音棚视觉,支持桌面端与移动端自适应展现,具备双人动作配合、吊挂麦克风与电影级暖光漫射。
什么是 Hotel Lobby AI 爆火趋势?
该趋势的核心魅力在于将经典舞台魅力与 AI 视频技术结合。Quavo 与 Takeoff 在 A COLORS SHOW 呈现的《Hotel Lobby》演出具有五大不可替代的视觉符号:
- 单色极简橙色录音棚:全哑光暖橙色墙面与地坪,营造出纯粹聚焦人像的舞台包裹感。
- 中心垂直悬挂麦克风:单根黑线悬吊着复古金属麦克风,成为双人说唱争抢的核心焦点。
- 生动默契的双人互动:一位主唱主导主歌伴以丰富手势,另一位在身旁点头律动、穿插和声。
- 稳定半身中景运镜:机位锁死在胸部以上至全身中景,专注展现肢体节奏与表情张力。
- 强节奏 808 口型对齐:歌词吐字利落,身体随着低音鼓点下沉起伏。
早期的创作者需要依赖复杂的绿幕抠像、手工遮罩和专业后期软件拼接;而现在通过 Riffuvo 创作平台,任何人都能在短短两分钟内完成全套制作。
为什么传统 2D 贴脸工具必然会崩坏?
很多新手初次尝试时,往往会尝试市面上的普通换脸软件,但导出的成片往往面部僵硬、像一张漂浮的贴纸。这是由传统贴脸与全身动作传递的底层技术差异决定的:
【传统 2D 贴脸工具】
静态正面照 ──> 强行扭曲为平面贴图 ──> 糊在原视频脸部图层上
致命缺陷:只要人物侧头超过 30° 或麦克风经过面部 ──> 产生严重畸变、撕裂与假面感

【Riffuvo 动作传递与身份锚定引擎】
双人照片 ──> 3D 人脸网格与面部身份锚定 ──> 全身骨骼动作传递 ──> 前置场景母版渲染
核心优势:大角度侧头自然、眼部微动逼真、悬吊麦克风穿过面部无撕裂
1. 麦克风物理遮挡难题(Occlusion)
在说唱过程中,演员会频繁靠近悬挂麦克风。当麦克风金属网格划过面颊和嘴唇时,低端算法会把麦克风误识别为人脸的一部分,导致嘴唇和鼻子瞬间模糊成团。
2. 下颌与侧颜大角度转动
说唱不仅是嘴皮子动,更伴随着头部大幅度摆动、下巴微扬与侧脸对视。简单的正脸粘贴无法生成侧脸轮廓,导致成片失真。
为了彻底攻克这一痛点,Riffuvo 深度协同 Veo 与 Seedance 视频生成引擎,配合前置场景母版技术,确保五官特征在剧烈运动中依然稳定如初。欲深入了解技术细节,可参阅我们的 Hotel Lobby AI 换脸与动作专题。
步骤一:准备两位主角的高清正面特写照片
高质量的输入素材是生成逼真视频的关键。遵循以下影棚标准准备人像照片:
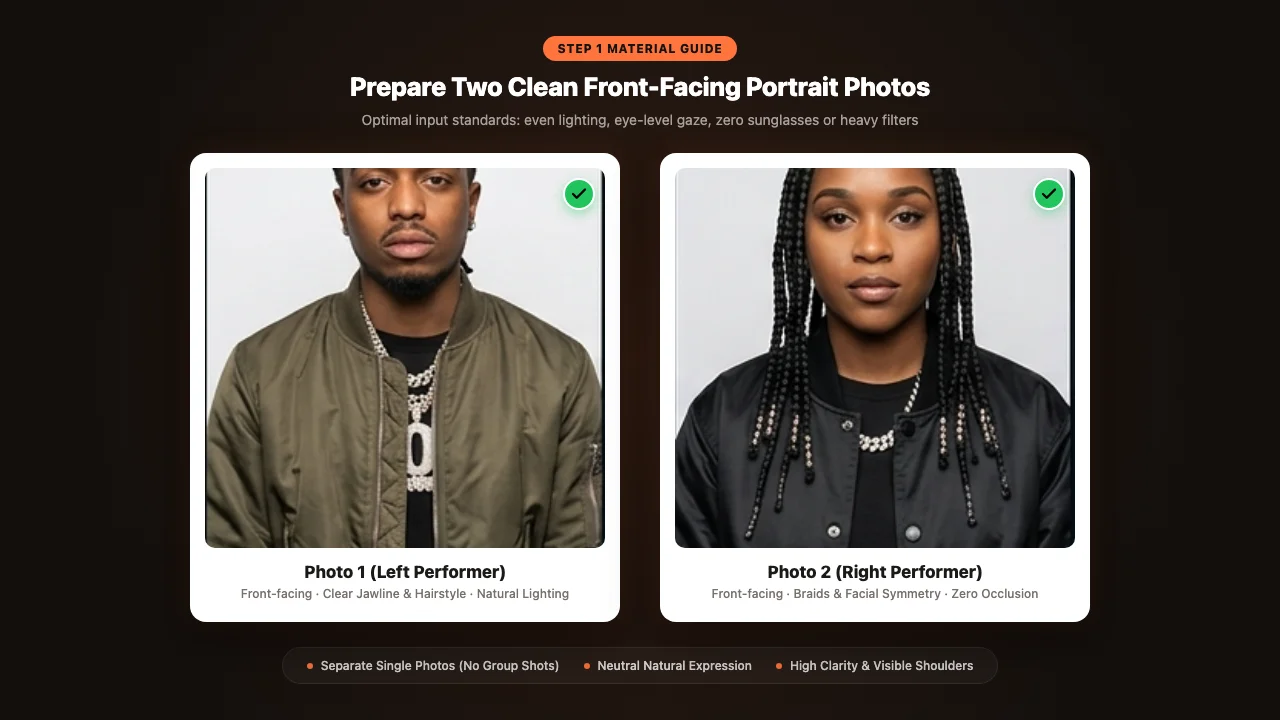
优质人像照片规范示例。自然平光、正面视线、五官清晰无遮挡、半身构图。
优质照片的 4 个要点:
- 直视镜头:面部朝向正前方,视线平视相机,神态自然自信。
- 光线均匀充足:采用柔和的自然光或影棚光,避免半边脸深暗的阴阳脸效果。
- 五官清晰露面:额头、双眼、鼻梁与唇部轮廓完整可见。
- 中景半身构图:建议包含肩颈线条,有助于 AI 更好地生成服饰过渡。
需严格避免的误区:
- 切勿佩戴深色墨镜:深色镜片会遮盖眼窝与瞳孔,导致 AI 无法生成眼神灵动感。
- 避免过度美颜磨皮:过度磨皮会抹去皮肤肌理与毛孔轮廓,降低画面的真实质感。
- 请勿上传合影截图:务必分别上传两张独立单人照片,避免算法混淆双人身份特征。
步骤二:选配影棚角色与母版引擎
照片准备就绪后,直接进入 Hotel Lobby 创作工作台 进行角色配置:
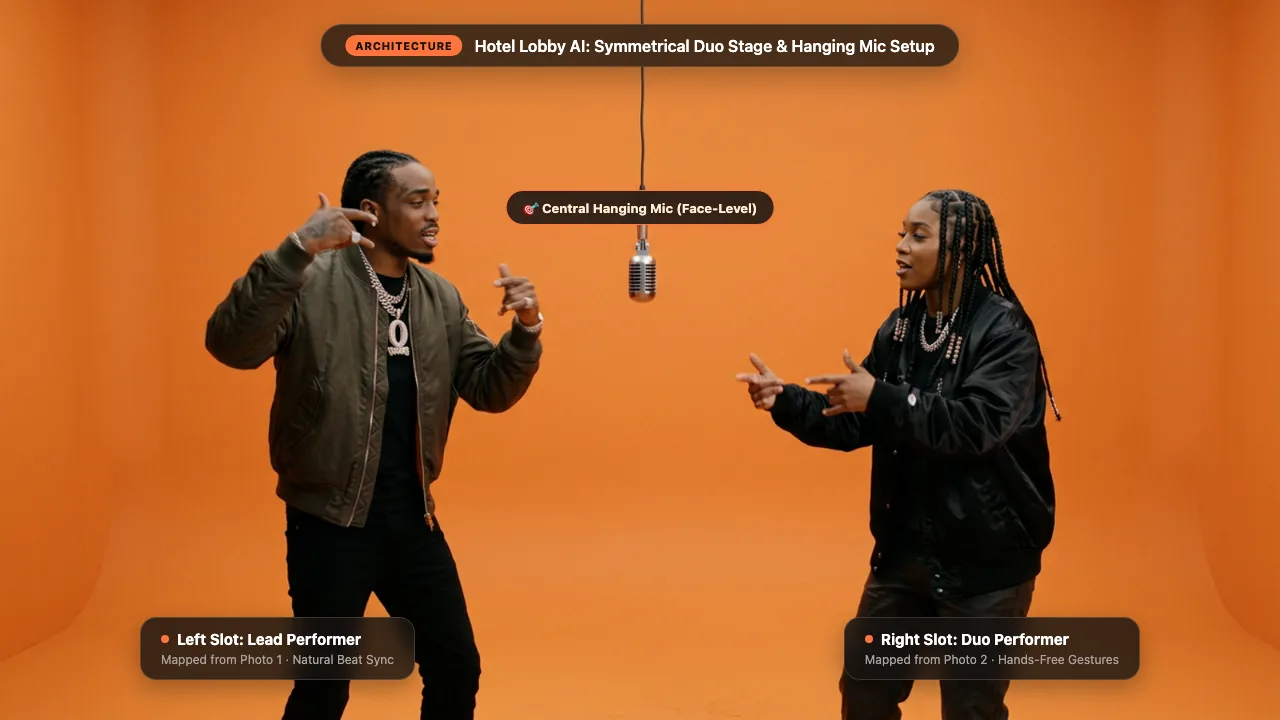
纯净录音棚环境,中央垂吊电容麦克风,左右双人站位防遮挡布局。
分配左右角色站位
原版舞台的两位表演者具有明确的角色分工:
- 左侧角色(主唱主攻):负责快节奏主歌押韵,手臂手势丰富,频繁前倾靠近麦克风。
- 右侧角色(副歌律动):随着 808 重低音身体起伏律动,适时上前接唱和声并负责气势衬托。
根据两位主角的气质分配站位,效果会更加自然。如果想选用更多样化的机位与舞蹈动作,可探索 Hotel Lobby AI 模板专题。
选择影棚生成引擎(Veo & Seedance)
- Veo 引擎:在电影级景深、光影氛围与面部微表情上表现优异,画质细腻入微。
- Seedance 引擎:擅长快节奏舞蹈律动、大幅度手臂说唱动作以及高强度节拍对齐。
步骤三:骨骼动作传递与两阶段身份合成
点击 立即生成 按钮后,后台将执行严密的多阶段推理计算:
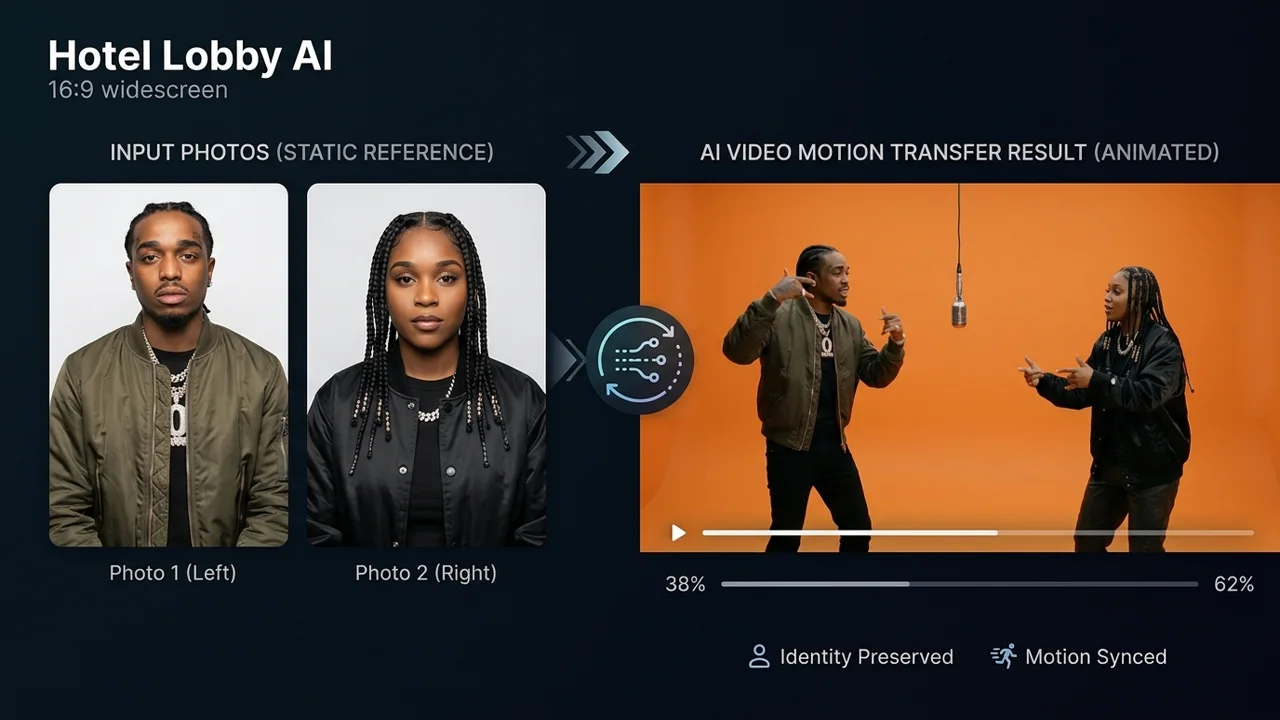
双人说唱动作传递与两阶段身份合成示意,消除面部扭曲与麦克风穿模。
- 五官与骨骼提取:从上传的照片中精准提取 68 个面部特征点与 18 个骨骼关节坐标。
- 前置母版分层合成:在光线映射时,预先建立悬挂麦克风与人物之间的前后物理遮挡层级。
- 动作流平滑过渡:根据原版节拍的运动向量逐帧插值,消除手臂穿模与肢体抖动。
步骤四:原声伴奏对齐与一键导出
说唱视频的精髓在于音画卡点。很多外部工具生成的视频没有声音,需要创作者手动导入剪辑软件对音频,稍有不慎口型就脱节。Riffuvo 在生成时实现了自动对齐:
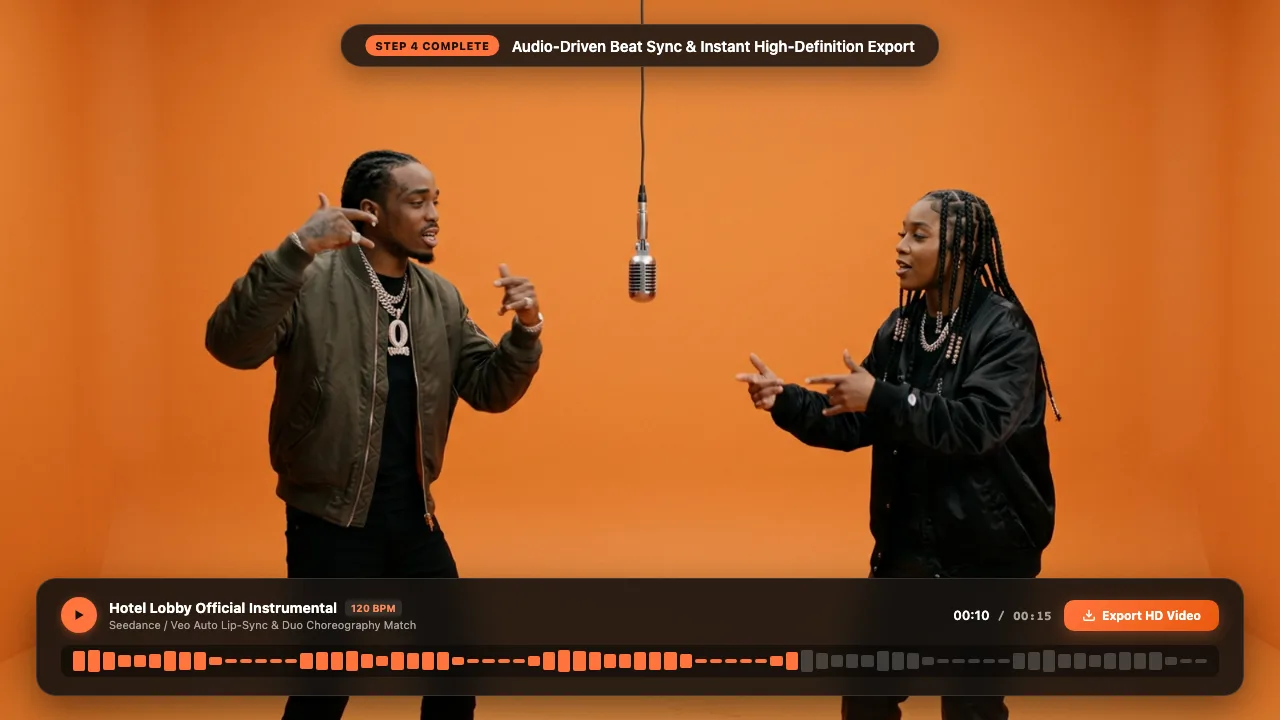
音画卡点与口型对齐成片预览,支持一键导出发布。
- 经典音频无损内置:内置经典的 10 秒与 15 秒原版伴奏,生成时直接卡在鼓点下落处。
- 高保真口型适配:嘴唇开合幅度与歌词音节严谨匹配,杜绝“假唱感”。
- 竖屏比例直出:成片采用标准的竖版 9:16 画幅,支持直接发布至抖音、小红书、视频号及海外社媒。
示例视频:实机说唱表演效果
点击观看示例视频,直观感受动作传递、影棚光感融合与原声卡点的实际呈现:
注意观察角色在靠近中央麦克风时的头部微动、肢体手势以及自然的光影反射,完全杜绝了传统贴脸工具的撕裂缺陷。
5 个进阶避坑实用技巧
为了让你的作品在社交平台获得更高播放量,推荐掌握以下制作诀窍:
| 技巧要点 | 实操策略 | 核心价值 |
|---|---|---|
| 1. 衣服色彩反差 | 建议两人穿不同明暗的服装(如一深一亮) | 增强双人视觉层次,在纯橙色背景下更加吸睛立体。 |
| 2. 露出清晰颈线 | 照片避免高领或大围巾遮挡颈部 | 利于算法在脖颈与胸前自然挂载古巴链等嘻哈配饰。 |
| 3. 头顶微侧角度 | 照片中下巴微扬或有 5° 自然侧偏 | 摆脱呆板证件照感觉,赋予成片自然的街头说唱态度。 |
| 4. 分辨率充足 | 原图分辨率建议在 800×800 像素以上 | 保障快速晃头时眼球反光与睫毛细节清晰锐利。 |
| 5. 善用免费额度 | 新用户注册即领 20 免费积分 | 充分尝试不同照片组合,满意后可参考 套餐方案 获取更多额度。 |
常见问题解答(FAQ)
Hotel Lobby AI 视频和普通的文本生视频有什么不同?
普通的文本生成视频机位和人物长相经常不可控漂移;而 Hotel Lobby 工作流锁定在标志性的极简橙色录音棚和悬吊麦克风场景下,只迁移你指定的人物五官和服饰风格,保证了极高的稳定性与辨识度。
可以使用动漫角色或宠物照片制作吗?
完全可以!Riffuvo 的动作引擎支持将真人动作投射到高质量 3D 渲染角色、二次元立绘甚至萌宠面孔上,带来极富创意的反差喜剧效果。
生成一个视频通常需要多长时间?
在我们的云端 GPU 集群上,单段视频的生成耗时通常在 60 至 90 秒之间,页面会实时展示当前队列进度。
导出的视频有水印吗?
使用新用户赠送的 20 积分生成的免费体验视频会带有轻量标识;在 套餐价格页面 升级付费额度后,即可随时下载超清无水印版本。
延伸阅读与相关指引
继续探索更多 AI 音乐说唱视频玩法:
- Hotel Lobby AI 创作工作台:上传两张照片,即刻免费领取 20 积分开始创作。
- Hotel Lobby AI 模板专题:探索精选预制舞蹈运镜与多款音频时长的模板组合。
- Hotel Lobby AI 换脸与动作专题:深度揭秘两阶段身份锁定与悬吊麦克风防遮挡架构。
- 套餐价格与积分方案:查看灵活实惠的积分包与月订阅特权。